Une application commence presque toujours par trois phrases dites à l’oral. Entre ces trois phrases et la première ligne de code, il y a des décisions que personne ne prend, des règles que personne n’écrit, et des oublis qu’on découvre en recette. Besoin → Plan est la méthode de LMVI pour franchir cet intervalle sans trou : elle descend du besoin aux épics, aux fonctionnalités et aux user stories, en tire les tests, fait relire chaque pièce par un agent extérieur, et laisse derrière elle une documentation qu’un assistant peut interroger. Une skill de Claude Code la déroule d’elle-même sur un dossier donné. Depuis le 26 octobre 2026, la méthode, son kit et la skill sont publiés en source ouverte sur GitHub. Voici précisément ce qu’elle fait, ce qu’elle impose, pourquoi les méthodes « spec-driven » du marché ne suffisaient pas, et ce qu’elle a coûté sur un chantier réel.
Le problème
Un agent de développement va vite. Trop vite, si rien ne le retient : il code la première interprétation du besoin, invente ce qui manque, et présente un résultat propre qui répond à une question que personne n’a posée. Le défaut n’est pas la vitesse, c’est l’absence de point d’arrêt. Le commanditaire n’a jamais eu l’occasion de dire « oui, c’est ça » avant que le code existe.
La méthode est née de la conception réelle de l’Atelier de décomposition de Régie, l’application des metteurs en scène, puis a été révisée après une revue critique. Elle a ensuite été appliquée à IdéeBox, à l’automne 2026, avec un journal de bord qui mesure chaque étape. C’est ce chantier qui sert d’exemple ici.
Trois principes avant la chaîne
La preuve externe. Tout artefact doit être prouvé par quelque chose qui n’est pas lui. Une exigence par son test, une règle de gestion par le contre-exemple qu’elle rejette, une phase par sa démonstration, une sauvegarde par sa restauration, une spécification par un relecteur qui ne l’a pas écrite. Ce qui n’a pas de preuve externe est, selon les mots de la méthode, une opinion bien formatée.
Trois axes qu’on ne mélange jamais. Le métier dit ce qu’on promet : des user stories regroupées en fonctionnalités, elles-mêmes regroupées en épics. La technique dit avec quoi on le fait : des workers, des services, des paquets. La livraison dit quand et comment on le montre : des phases, chacune fermée par une démonstration. Un artefact ne porte qu’un axe. Le seul endroit où les trois se croisent est la matrice de couverture, qui trace chaque promesse jusqu’à sa brique, son test et sa démonstration.
Décider avant de construire. Les décisions structurantes se prennent avant le plan, s’écrivent avec leur pourquoi, et rien ne se code tant qu’une décision bloquante est ouverte. Le doute n’est pas interdit. Il est marqué « à arbitrer », puis tranché, jamais enfoui dans le code.
La chaîne : huit maillons, six arrêts
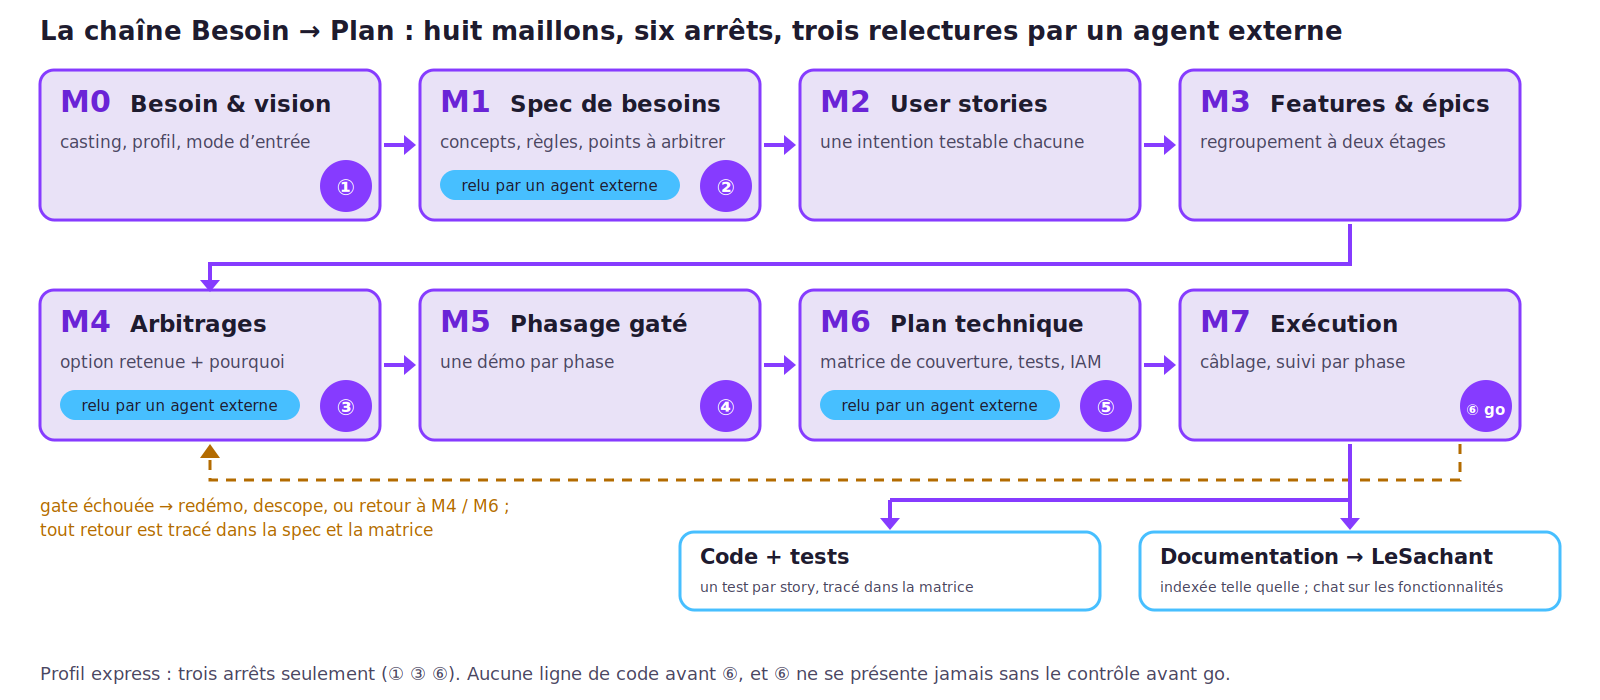
Chaque maillon a une entrée, un livrable, des règles et une définition du fini.
- M0, besoin et vision. Trois à cinq lignes de vision, le principe directeur, les acteurs, le casting du chantier, le profil et le mode d’entrée. Règle : reformuler et faire confirmer avant d’écrire quoi que ce soit d’autre. Fini quand le commanditaire dit « oui, c’est ça ».
- M1, spécification de besoins. Les concepts et le vocabulaire, le modèle d’entités, les règles de gestion en fiches, la matrice des habilitations rôle par rôle, les exigences non fonctionnelles. Le quoi, jamais le comment. Les points non tranchés sont marqués à arbitrer. Relecture externe requise.
- M2, user stories. Une intention testable par story, numérotée, sans aucune solution technique dedans. La fiche ne dit ni dans quelle phase ni dans quelle brique elle vivra.
- M3, fonctionnalités et épics. Le regroupement à deux étages. Chaque story a exactement une fonctionnalité propriétaire, chaque fonctionnalité exactement un épic, aucun vide.
- M4, arbitrages. Le maillon qu’on oublie. Chaque point ouvert reçoit des options, une recommandation, et une décision écrite avec son motif. On ne passe pas au plan tant qu’une décision structurante est ouverte. Relecture externe requise.
- M5, phasage. Des phases, chacune livrée avec une porte de sortie qui est une démonstration réelle. « On voit X marcher », jamais une liste de tâches cochées.
- M6, plan technique. Pour chaque phase : ce qu’on ne code pas parce que la plateforme le fournit, les briques nouvelles choisies par nature, chacune avec sa référence dans les catalogues de la plateforme, le modèle de données, la matrice de couverture, le plan de test et le passage des habilitations vers l’IAM de la plateforme. Relecture externe requise.
- M7, exécution. Le câblage concret : où va le code, quels intrants techniques, quels outils de la plateforme, quelle cible d’exécution, et un dossier de suivi par phase.
Six arrêts jalonnent la chaîne. Le commanditaire confirme la vision, signe la spécification, tranche les arbitrages, valide le phasage, valide le plan, et donne le go. L’arrêt du go ne se présente jamais nu : le pilote déroule d’abord une grille de contrôle avant go, lance un script qui vérifie les points mécaniques, et présente la grille remplie avec son verdict. Tout écart non levé bloque le go.
Relu par un autre agent, et c’est Claude qui le pilote
C’est le point qui distingue le plus la méthode. La spécification, les arbitrages et le plan technique ne sont pas relus par celui qui les a écrits, ni par une seconde session du même modèle, que la méthode qualifie de relecture de confort. Ils sont relus par un agent extérieur, différent en nature : un autre modèle de langage, installé sur la machine et lancé en ligne de commande — opencode par défaut —, ou un humain du métier.
Le déroulé est toujours le même. Claude, qui pilote le chantier, rédige le livrable. Il lance ensuite l’agent relecteur avec une consigne adversariale : lire les fichiers, chercher les contradictions, les règles sans contre-exemple, les acteurs sans habilitation, les stories sans critère d’acceptation. Il archive la sortie brute du relecteur dans le dossier du chantier, sans la retoucher, parce que c’est elle qui fait preuve. Il corrige ce qui doit l’être, puis présente au commanditaire le livrable avec la liste des défauts trouvés et de ce qui en a été fait. Si le relecteur prévu est indisponible, Claude le dit et demande lequel employer ; il n’a pas le droit de présenter sa propre relecture comme externe.
Le relecteur n’a pas écrit la pièce, n’a pas le même modèle, n’a pas les mêmes angles morts. Une spécification qui sort de là a été contredite au moins une fois avant d’être signée. C’est la preuve externe appliquée à la méthode elle-même.
Des épics aux tests, puis à la documentation que LeSachant interroge
La chaîne ne produit pas un document, elle produit une hiérarchie. En M2, chaque intention devient une user story testable, avec ses critères d’acceptation. En M3, les stories sont rangées en fonctionnalités, une fonctionnalité étant une capacité qu’on peut démontrer, et les fonctionnalités en épics, qui sont des thèmes de valeur. Chaque story a exactement une fonctionnalité propriétaire, chaque fonctionnalité exactement un épic, aucun n’est vide. Un petit chantier crée tout de même ses épics, même s’il n’en a qu’un ou deux.
Cette hiérarchie est ce qui rend les tests possibles. La matrice de couverture du plan technique suit chaque story jusqu’à son épic, sa phase, sa brique, et ses tests, avec une colonne de statut. Un test ne se justifie pas par l’inspiration du développeur : il existe parce qu’une story l’exige, et une story sans test est visible dans la matrice comme un trou. Le plan de test de chaque phase se déduit de là, et la démonstration qui ferme la phase rejoue les stories qu’elle promettait.
Une story d’écran demande deux preuves : son test de services, et un parcours au navigateur, joué dans le rôle de la personne et à la taille d’une vraie fenêtre. La règle vient de Your360. En une soirée, le 26 octobre 2026, cinq défauts d’écran y sont apparus, que 202 tests de services au vert n’avaient pas vus. Le commanditaire et les parcours au navigateur les ont trouvés : un bouton muet, un texte qui contredisait l’état réel, une page sans issue, un panneau sans ascenseur. Une capture pleine page montrait ce panneau entier. Personne ne pouvait pourtant en atteindre le bas.
Le dernier produit de la chaîne est la documentation. Spécification, fiches de règles, stories, arbitrages avec leur pourquoi, matrice : tout cela décrit l’application en termes de fonctionnalités, pas de fichiers. C’est exactement la matière dont LeSachant a besoin. LeSachant est l’application de la flotte à qui l’on pose des questions sur une autre application : « comment marche telle fonction ? », « à quoi sert ce worker ? », « que se passe-t-il si l’auteur n’est pas connu ? ». Elle indexe la documentation et le code source dans un moteur de recherche hybride, et répond en citant ses sources. Son chat est concentré sur les fonctionnalités de l’application interrogée : il ne parle que de ce que la documentation dit, et dit quand elle ne dit rien. Sur SDR2, son premier corpus, elle tient 527 documents découpés en 4 154 morceaux, et ses réponses sont mesurées sur un banc de trente questions rejoué à chaque réglage.
Une documentation écrite après coup, à partir du code, se reconstitue à grands frais. Une documentation produite par la chaîne existe avant le code, tracée jusqu’aux tests, relue par un tiers : LeSachant l’indexe telle quelle, et ses réponses héritent de cette relecture.
Ne rien recoder : chaque brique cite sa fiche
C’est au plan technique qu’un agent réécrit, sans le savoir, ce que la plateforme rend déjà : un envoi de courriel, un coffre à secrets, un disjoncteur. « Réutiliser la plateforme » ne suffit pas comme consigne. Il faut dire où regarder, et dans quel ordre.
Le squelette d’application de TheSocle porte deux catalogues, qui ne répondent pas à la même question. Le premier recense les services du Hub, en 44 guides : quel service je consomme au lieu de le recoder ? Le second décrit les mécanismes du framework, en 148 fiches : par quel mécanisme j’écris ce qui reste dans mon code ? Ces deux chiffres ont été relevés le 27 octobre 2026.
Depuis ce jour, chaque brique du plan technique est routée avant d’être écrite. On cherche d’abord un service, puis un mécanisme. Si rien ne couvre le besoin, la brique est marquée « non couverte » avant la première ligne de code, et le catalogue s’enrichit une fois la solution trouvée. L’ordre compte. Interrogé à l’envers, l’agent écrit dans son code ce que la plateforme fournit.
La version publique livre ces deux catalogues comme point de départ : quatre fiches rédigées pour montrer le niveau attendu, et les 186 autres en gabarits, titre et besoin posés, à réécrire pour sa propre plateforme.
Le contrôle avant go lit la table de routage. Il refuse une brique sans référence, et vérifie que chaque guide ou fiche cité existe. Une référence inventée bloque le go comme un oubli. La version publique garde la règle et laisse chaque plateforme déclarer ses propres catalogues.
Pourquoi pas la méthode SDD du marché
Le « spec-driven development », SDD, est l’approche que proposent les outils d’agents de code depuis 2025 : Spec Kit chez GitHub, les specs de Kiro chez Amazon. L’idée est la bonne, et c’est la même : écrire la spécification avant de laisser l’agent coder. D’après leur documentation publique au 26 octobre 2026, Spec Kit enchaîne une constitution du projet, une spécification par fonctionnalité avec des user stories et des identifiants d’exigence, un plan technique, une liste de tâches, puis l’implémentation. Kiro produit trois fichiers par spec : les exigences en notation EARS, la conception, les tâches, avec un point de revue entre chaque phase.
Ce que nous n’y avons pas trouvé, et dont nous avions besoin :
- Un relecteur différent en nature. Dans les deux cas, la relecture prévue est celle de l’utilisateur, aidé au besoin par l’agent qui a écrit la spécification. Aucune étape n’impose un autre modèle, ni n’archive sa sortie comme preuve. La relecture de confort est la norme.
- Les arrêts du commanditaire comme contrat. Il existe des points de revue, mais rien ne bloque mécaniquement le passage au code tant qu’une décision structurante est ouverte, et rien ne consigne les arbitrages avec leur motif comme un livrable à part.
- La hiérarchie épics, fonctionnalités, stories. Les deux outils travaillent au niveau de la fonctionnalité, une spec par fonctionnalité. Il n’y a pas d’étage au-dessus pour voir le périmètre entier, ni de règle qui interdise une story orpheline.
- La matrice de couverture jusqu’aux tests. Les tâches portent une étiquette de story, mais aucune matrice ne trace chaque story vers sa brique, sa phase, ses tests et son statut, et aucune porte de phase n’exige une démonstration.
- Le routage vers ce qui existe déjà. Le plan décrit ce qu’il faut construire. Rien n’oblige à vérifier, brique par brique, que la plateforme ne le fournit pas.
- La documentation comme produit. Les fichiers de spec servent à produire le code, puis restent dans un dossier. Rien n’est pensé pour qu’un assistant les indexe et réponde dessus.
Aucun de ces manques n’est un défaut de ces outils : ils visent le développeur seul devant son agent. Nous visions autre chose, un commanditaire qui décide, une preuve extérieure à chaque pièce, et une documentation qui survit au chantier dans LeSachant. C’est pour cela que la méthode a été écrite plutôt qu’adoptée, en gardant de SDD ce qui marche : la spécification avant le code, et des artefacts en Markdown dans le dépôt.
Deux modes d’entrée, trois profils
Le besoin arrive de deux façons. Besoin exprimé : quelques phrases, du vrac, de l’oral. M0 et M1 s’écrivent en reformulant. Cahier des charges fourni : un document existe, parfois long. M0 et M1 s’en extraient, chaque story et chaque règle référence son paragraphe d’origine, et les trous du document deviennent les points à arbitrer. Zéro invention : rien qui ne soit dans le document ou tranché en M4.
Le profil règle le niveau d’outillage, jamais la taille des documents. Express : trois arrêts seulement, vision, arbitrages, go, pour une fonctionnalité courte sans enjeu contractuel. Solo : les six arrêts et la chaîne complète, pour une application interne. Client : les six arrêts, un procès-verbal à chaque porte, et deux piliers de plus, la conformité et l’exploitation.
En deçà d’un seuil, la méthode dit de ne rien dérouler. Si l’intention tient dans un message et se prouve par un test, on fait, on prouve, on journalise. Une méthode déroulée sur un correctif de deux heures est le meilleur moyen de la faire contourner ensuite.
Quand le réel contredit le papier
Une phase dont la démonstration échoue ne se ferme pas. L’échec est consigné, puis une décision est écrite : refaire la démonstration après correction, retirer des stories du périmètre, ou revenir à un maillon amont. Un apprentissage de M7 qui invalide la spécification se propage en arrière, tracé : la spécification gagne une ligne dans sa section des révisions, la matrice de couverture change avec sa date. Une story n’est jamais supprimée : elle devient scindée ou abandonnée, avec sa raison.
La méthode sait aussi arrêter un chantier. Deux portes consécutives ajournées sur la même phase, ou un budget consommé sans valeur démontrée, déclenchent une proposition d’arrêt. Le pilote propose, le commanditaire décide, un retour d’expérience est obligatoire. Un chantier arrêté proprement vaut mieux qu’un chantier zombie.
La skill : ce qu’elle fait, et ce qu’elle s’interdit
La skill besoin2plan est une consigne versionnée que Claude Code charge sur demande. Elle prend un répertoire cible en argument et pilote le chantier qui vit dans docs/chantier/ de ce répertoire. Elle embarque le kit de la méthode, publié en version 1.2.0 : le document de référence, les profils, le prompt pilote, dix-huit gabarits de conception, cinq de conformité et quatre d’exploitation, un générateur de fiches et de squelettes de tests, et le script de contrôle avant go.
Son déroulé tient en cinq étapes. Elle résout l’argument en chemin absolu et refuse de continuer sans répertoire. Elle localise ou monte le chantier : si le kit est présent, c’est lui l’autorité, quelle que soit sa version ; sinon elle crée l’arborescence des maillons et y copie le kit. Elle détermine le mode : reprise si un journal de pilotage existe, qu’elle lit en entier avant de reprendre là où le chantier s’était arrêté ; sinon entrée à froid, avec un cahier des charges s’il y en a un dans docs/specifications/, ou le besoin en trois phrases demandé à l’utilisateur. Elle exécute ensuite le prompt pilote du kit, dont les règles priment sur toute habitude. Elle répond enfin en cent cinquante mots au plus : la cible, la version du kit, le mode, le maillon atteint et la décision attendue.
Ce qu’elle s’interdit compte autant. Le kit est en lecture seule pendant tout le chantier, même pour corriger une erreur manifeste : une friction se consigne dans un fichier dédié, une ligne par friction, et nourrira le retour d’expérience. Aucun code avant le go, pas même un squelette « pour gagner du temps ». La relecture externe est une preuve : si le relecteur prévu est indisponible, la skill le dit et demande lequel employer, et ne présente jamais sa propre relecture comme externe. Un seul chantier à la fois par cible. Aucun commit sans demande. Et si le besoin est sous le seuil, elle le signale au lieu de monter un chantier.
Ce que ça a coûté sur IdéeBox
IdéeBox est une boîte à idées d’entreprise : on dépose une idée par courriel, elle est analysée automatiquement, l’auteur reçoit un accusé honnête, et les idées validées s’affichent sur un mur collectif. Le chantier a été mené en profil express, mode cahier des charges fourni, sur un brief de 142 lignes.
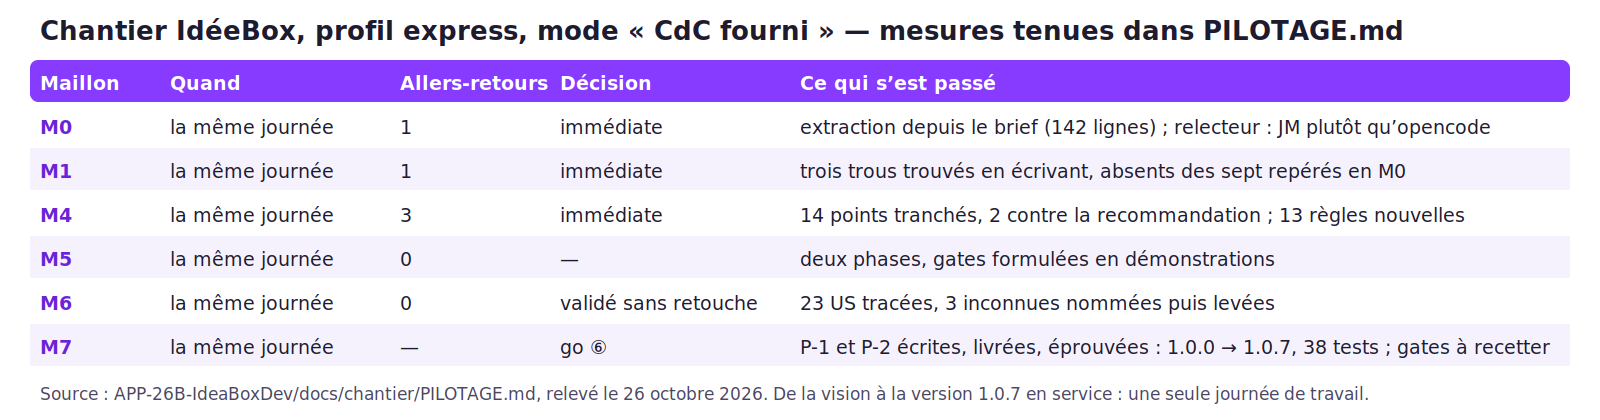
Ce que les chiffres disent. Toute la chaîne a tenu dans une seule journée de travail, avec un seul aller-retour pour la vision et trois pour les arbitrages. Quatorze points ont été tranchés, dont deux contre la recommandation du pilote. Treize règles de gestion nouvelles en sont sorties, dont six nées d’une seule question sur la modification d’une idée. Le plan technique a tracé vingt-trois stories jusqu’à leur brique et leurs tests, et nommé trois inconnues au lieu de les masquer. Il a été validé sans une retouche.
Le go donné, les deux phases ont été écrites, livrées sur le Hub et éprouvées dans la même journée, de la version 1.0.0 à la 1.0.7, avec trente-huit tests. De trois phrases de vision à une application en service, sans qu’une ligne de code ait précédé une décision. Les portes restaient à recetter par le commanditaire, ce que le journal dit tel quel.
Le chantier a aussi relevé trois frictions avec le kit, sans le corriger. Le kit vendorisé ne portait pas de fichier de version, et les en-têtes de chaque fichier allaient de 1.4.0 à 1.7.0 : annoncer l’un d’eux comme version du kit aurait été faux. Le gabarit de vision n’avait pas d’emplacement pour les questions ouvertes repérées en lisant le cahier des charges, alors que c’est le premier produit utile de la lecture. Et le pilote impose de présenter les arbitrages un par un, ce qui aurait fait huit allers-retours pour un chantier de quelques heures : ils ont été présentés en une passe. Ces trois lignes ont donné le fichier de version et une partie de la version interne du kit dont la première version publique est issue.
Ce que ça ne fait pas encore
Plusieurs règles de la méthode sont encore marquées « candidates » : elles viennent d’un seul chantier et attendent d’être confirmées sur un second. Le relecteur externe par défaut est un autre modèle piloté en ligne de commande ; sur IdéeBox, le commanditaire a préféré relire lui-même, ce qui est une preuve externe valable mais ne mesure pas la relecture automatique. Les piliers conformité et exploitation du profil client n’ont pas encore été déroulés sur un chantier contractuel. Et la méthode ne remplace pas la recette : les portes d’IdéeBox attendaient toujours leur démonstration devant le commanditaire au moment de l’écriture de cet article.
Où trouver les sources
Tout est public, sous licence ouverte, dans le dépôt github.com/Lmvi-Conseil/besoin2plan :
- la méthode complète : le document de référence, les profils, le prompt pilote, les gabarits des trois piliers, conception, conformité et exploitation ;
- le générateur de fiches, de matrice de couverture et de squelettes de tests, avec un jeu de données complet issu d’un chantier réel ;
- le contrôle avant go, avec la vérification du routage de chaque brique, et l’exemple réel du contrat d’architecture de TheSocle pour écrire le vôtre ;
- la skill Claude Code, qui s’installe en une commande et se lance par
/besoin2plan <répertoire>.
La version 1.2.0, publiée le 27 octobre 2026, propose deux archives : le kit seul, à déposer dans le dossier de votre application, et la skill avec son kit. La méthode et les gabarits sont sous licence Creative Commons Attribution 4.0, les scripts sous licence MIT.
Le journal de pilotage d’IdéeBox reste privé : ses chiffres sont repris tels quels plus haut. LeSachant, qui interroge la documentation ainsi produite, fera l’objet de son propre article dans cette série. Une présentation en direct, sur un besoin de votre choix, se fait sur demande.